再登国际顶刊!东软医疗让医学AI学会“自查自纠”
近日,东软医疗创新研究院联合澳门大学和香港城市大学等团队,提出医学概念自主校准框架ConChecker,相关论文以《Trustworthy Medical Concept Recalibration through Logic-Aware Multimodal Evidence Fusion》为题,发表于国际AI领域顶级期刊《Information Fusion》(JCR Q1,IF:17.4)。
医学AI不仅要“答对”,更要“说清为什么对”,还要能发现并纠正自己的错误。ConChecker把关注点从“结果是否正确”延伸到“依据是否可靠”,为可信、可解释的医学AI提供了新路径。
01
从人工逐项纠错,到AI主动核验
在部分可解释医学AI模型中,系统会先识别病灶形态、边界等特征,再据此进行疾病分类。这些特征就是模型判断的“依据”。一旦识别有误,往往需要医生逐项复核、手动修正,病例越多,核查负担越重。
研究团队将视觉语言模型、逻辑证据验证与策略优化相结合,构建“推理—核验—校准”的自动化流程:先从医学图像中提取特征描述,再逐项检查证据是否支持原有判断,对存在矛盾的特征预测进行校准。同时,以分类结果和特征识别的正确性为反馈,持续优化校准策略,让AI具备主动核查依据、自主修正偏差的能力。
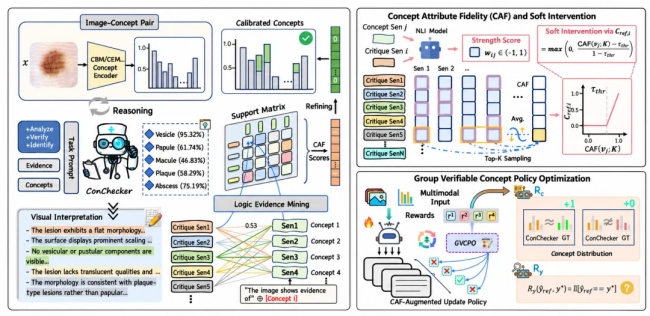
ConChecker总体技术框架:视觉语言推理、CAF逻辑证据验证、软概念干预与GVCPO可验证策略优化
02
多场景验证,实力经得起检验
研究在皮肤镜、临床皮肤图像、乳腺超声和外周血细胞四类医学图像基准上开展验证,并在另外四个未参与训练的数据集上测试处理新数据的能力,全部核心实验均进行五次独立运行。
在无需人工修正的条件下,该框架在皮肤镜和乳腺超声数据上的疾病分类准确率分别达到86.42%和85.47%。对比实验中,传统方法通常需要医生人工修正8~14次,性能才趋于稳定;该框架则全程无需人工介入,单例推理仅约11秒,而医生人工修正一次约需25秒。
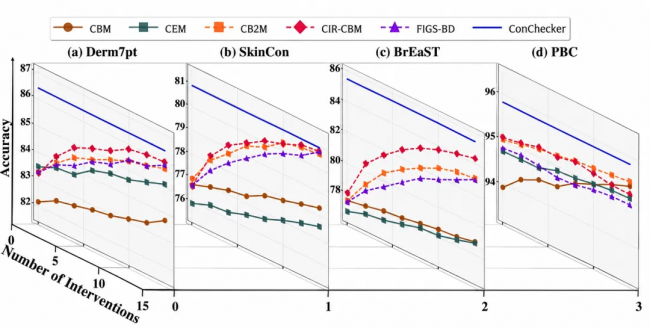
不同方法的人工干预次数与诊断性能对比:ConChecker在零人工干预条件下完成自主概念校准
研究还邀请五名平均临床经验达12年的执业医生,对模型的判断准确性、特征一致性、推理质量及临床使用价值进行评价,结果显示该框架在多项维度获得较高评分。
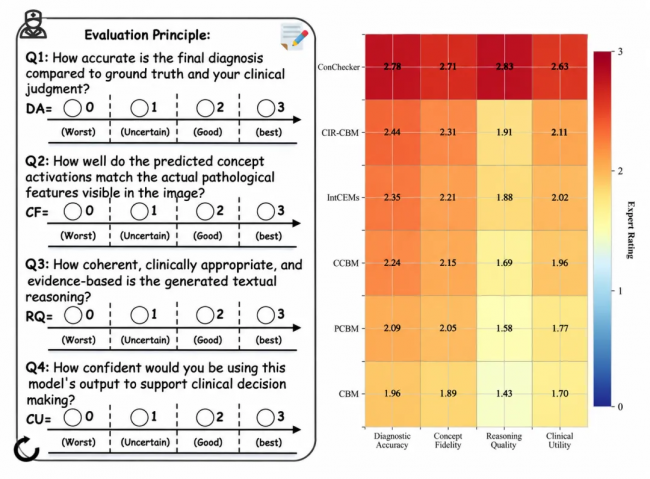
临床专家评价结果:从诊断准确性、概念一致性、推理质量和临床使用价值四个维度评价模型输出。
03
持续创新,推进可信医学AI研发
该框架采用模块化设计,无需改变原有模型主体结构,即可接入已有可解释医学AI系统,为拓展更多影像任务提供技术基础。
未来,东软医疗将持续推进医学多模态模型与可信AI研发,在更复杂的真实临床环境中开展验证,减轻医生的重复核查负担,让医学AI更好地赋能临床、服务医生、惠及患者。